OpenClaw auf einem GPU-Server: warum die GPU für Ihren KI-Agenten zählt
OpenClaw ist der Open-Source-KI-Assistent, den dieses Jahr alle installieren: ein Gateway, das Sie auf Ihrem eigenen Rechner betreiben und das Ihre Chat-Apps mit einem KI-Agenten verbindet, der im Web surfen, Befehle ausführen, Dateien und Medien verarbeiten und Skills nutzen kann. Viele kaufen einen Mac mini nur, damit er dauerhaft läuft. Ein Server erledigt dieselbe Aufgabe, immer eingeschaltet und getrennt von Ihrem persönlichen Computer. Dieser Artikel erklärt, was eine GPU für OpenClaw auf einem Server ändert, anhand der Messungen aus unserem Test des Browsers für KI-Agenten.
Kurz gesagt
- OpenClaw steuert einen echten Browser (ein verwaltetes Chromium-Profil: Tabs, Klicks, Screenshots, PDFs). Ohne GPU zeichnet dieser Browser die Seiten mit dem Prozessor: In unserem Test lief eine WebGL-Seite in 1080p mit 13 Bildern/s bei 3,9 von 4 belegten vCPU. Mit der Intel UHD 770: etwa 260 Bilder/s bei 0,6 vCPU.
- Websites sehen eine echte Grafikkarte:
Intel UHD Graphics 770stattSwiftShaderoder gar kein WebGL, was ein typisches Merkmal eines automatisierten Browsers ist. - Die CPU bleibt frei für den Agenten selbst: das Gateway, seine Tools und Ihre Skills.
- Auch Medien und lokale Modelle können die GPU nutzen: Videokonvertierung mit Quick Sync, Bild- und Textmodelle mit OpenVINO.
OpenClaw selbst haben wir nicht gemessen: Die folgenden Zahlen stammen aus unserem Test von Chrome, gesteuert von einem KI-Agenten, auf derselben Hardware (4 vCPU, Intel UHD 770, Debian 13).
1. Was OpenClaw auf einem Server braucht
Laut der offiziellen Dokumentation:
| Bedarf | Was OpenClaw nutzt |
|---|---|
| Laufzeit | Node 24 oder 26, ein Gateway-Prozess (Linux, macOS, Windows/WSL2, Docker) |
| Modell | einen API-Schlüssel eines Anbieters oder lokale Modelle (einen Ollama-Server über seine native API) |
| Browser | ein verwaltetes Browserprofil (Chrome, Chromium, Brave oder Edge), das der Agent steuert: Tabs, Klicks, Tippen, Snapshots, Screenshots, PDFs |
| Zugriff | die Web Control UI lauscht auf 127.0.0.1: Sie erreichen sie über einen SSH-Tunnel oder Tailscale |
Der Browser ist der schwere Teil. Jede Seite, die der Agent öffnet, wird gezeichnet, gescrollt und als Screenshot aufgenommen, oft in einer Schleife. Genau hier kommt die GPU ins Spiel.
2. Der Browser: 20× schneller mit der GPU
Auf einem Server ohne GPU weicht Chrome auf SwiftShader aus, eine vom Prozessor emulierte Grafikkarte. Dieselbe WebGL-Seite in 1080p, Headless-Chrome, Server mit 4 vCPU:
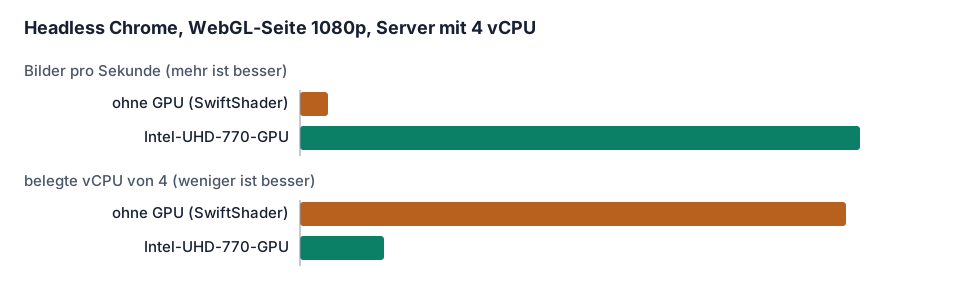
Für einen Agenten zählt die zweite Zeile genauso wie die erste: Wenn der Browser 3,9 von 4 vCPU belegt, warten das Gateway, die Modellaufrufe und Ihre Skills. Eine schwere Seite (eine Karte, ein Dashboard, ein Video) genügt, um den ganzen Assistenten auszubremsen.
3. Was Websites sehen
Websites, die Bots bekämpfen, lesen die vom Browser gemeldete Grafikkarte aus
(WEBGL_debug_renderer_info):
| Browser-Konfiguration | Gemeldete Grafikkarte |
|---|---|
| Server ohne GPU, Headless-Standard | SwiftShader (emuliert) |
| Server ohne GPU, virtueller Bildschirm | gar kein WebGL |
| Server mit der Intel UHD 770 | Intel UHD Graphics 770 |
SwiftShader oder fehlendes WebGL ist ein klassisches Zeichen für einen automatisierten Browser.
Eine echte GPU macht einen Agenten nicht unsichtbar, und Sie müssen die Bedingungen jeder Website
einhalten, aber sie beseitigt einen offensichtlichen Grund, blockiert zu werden oder endlose
Prüfungen zu sehen. Die Details und die verwendeten Chrome-Flags finden Sie in
unserem Artikel über den Browser für KI-Agenten.
4. Medien und lokale Modelle
OpenClaw verarbeitet Medien (Bilder, Audio, Video), die aus Ihren Chat-Apps gesendet werden. Auf unseren Servern bietet dieselbe Intel-GPU außerdem:
- eine Video-Engine (Quick Sync / VA-API), um Videos zu konvertieren oder zu verkleinern, ohne die CPU zu belasten: siehe unsere ffmpeg-Befehle für Quick Sync;
- OpenVINO-Unterstützung für Bilderkennung, OCR und kleine Sprachmodelle auf der GPU: siehe KI-Inferenz auf einer integrierten GPU.
Für das Hauptmodell bleibt eine gehostete API (Anthropic, OpenAI…) die leistungsfähigste Wahl; ein kleines lokales Modell, das Ollama bereitstellt, reicht für einfache Aufgaben und hält Ihre Daten auf Ihrem Server.
5. Warum ein Server statt Ihres eigenen Computers
- Isolation: OpenClaw kann Befehle ausführen und Dateien lesen. Auf einem eigenen Server sieht es nur, was Sie dort ablegen, nicht Ihren persönlichen Rechner.
- Immer eingeschaltet: Ihr Assistent antwortet nachts und wenn Ihr Laptop zugeklappt ist.
- Privater Zugriff: Lassen Sie die Web Control UI auf
127.0.0.1und erreichen Sie sie über einen SSH-Tunnel oder Tailscale, ohne offenen Port im Internet. Legen Sie mit den Allowlists von OpenClaw fest, wer mit dem Agenten sprechen darf.
6. Mac mini oder Linux-GPU-Server?
| Linux-GPU-Server (iGPU Start / Power) | Dedizierter Mac mini (M4) | |
|---|---|---|
| Preis | ab 14,99 € / 29,99 € netto pro Monat | ab 95 € pro Monat |
| Browser auf der GPU | ja, Intel UHD 770 | ja, Apple-GPU |
| Apple-exklusive Funktionen (iMessage, Apple-Apps) | nein | ja |
| Ideal für | einen ständig laufenden Agenten, der surft, Medien konvertiert und kleine lokale Modelle ausführt | Agenten, die macOS brauchen |
Beides gibt es bei uns: Wählen Sie den Mac mini nur, wenn Ihr Agent macOS braucht.
Welches Angebot?
iGPU Start (2 vCPU, 8 GB) reicht für einen Agenten, der ab und zu surft. Surft er den ganzen Tag, verarbeitet Videos oder betreibt ein lokales Modell neben dem Gateway, nehmen Sie iGPU Power (4 vCPU, 14 GB, doppelt so viel GPU-Leistung wie Start): Unsere Browserwerte wurden auf 4 vCPU gemessen.
Möchten Sie ihn einsatzbereit? Fragen Sie bei der Bestellung per E-Mail danach (contact@linuxgpu.eu): Wir können den Server mit den installierten Voraussetzungen für OpenClaw und einem für das Rendering auf der GPU eingerichteten Chrome ausliefern. Sie verbinden dann nur noch Ihr eigenes Modellkonto und Ihre Chat-Apps.
Ausprobieren
Angebote ansehen: iGPU-Server ab 14,99 € netto pro Monat, dedizierter Mac mini ab 95 € pro Monat.