OpenClaw sur un serveur GPU : pourquoi le GPU compte pour votre agent IA
OpenClaw est l’assistant IA open source que tout le monde installe cette année : une Gateway que vous faites tourner sur votre propre machine, qui relie vos messageries à un agent IA capable de naviguer sur le web, d’exécuter des commandes, de manipuler des fichiers et des médias, et d’utiliser des skills. Beaucoup achètent un Mac mini rien que pour le laisser allumé. Un serveur fait le même travail, toujours allumé, et loin de votre ordinateur personnel. Cet article explique ce qu’un GPU change pour OpenClaw sur un serveur, à partir des mesures de notre test du navigateur pour agent IA.
En bref
- OpenClaw pilote un vrai navigateur (un profil Chromium géré : onglets, clics, captures d’écran, PDF). Sans GPU, ce navigateur dessine les pages avec le processeur : dans notre test, une page WebGL en 1080p tournait à 13 images/s avec 3,9 vCPU occupés sur 4. Avec l’Intel UHD 770 : environ 260 images/s avec 0,6 vCPU.
- Les sites voient une vraie carte graphique :
Intel UHD Graphics 770au lieu deSwiftShaderou d’une absence totale de WebGL, signature typique d’un navigateur automatisé. - Le CPU reste libre pour l’agent lui-même : la Gateway, ses outils et vos skills.
- Les médias et les modèles locaux peuvent aussi utiliser le GPU : conversion vidéo avec Quick Sync, modèles d’image et de texte avec OpenVINO.
Nous n’avons pas mesuré OpenClaw lui-même : les chiffres ci-dessous viennent de notre test de Chrome piloté par un agent IA sur le même matériel (4 vCPU, Intel UHD 770, Debian 13).
1. Ce dont OpenClaw a besoin sur un serveur
D’après la documentation officielle :
| Besoin | Ce qu’utilise OpenClaw |
|---|---|
| Exécution | Node 24 ou 26, un processus Gateway (Linux, macOS, Windows/WSL2, Docker) |
| Modèle | une clé d’API d’un fournisseur, ou des modèles locaux (un serveur Ollama, via son API native) |
| Navigateur | un profil de navigateur géré (Chrome, Chromium, Brave ou Edge) que l’agent contrôle : onglets, clics, saisie, instantanés, captures d’écran, PDF |
| Accès | la Web Control UI écoute sur 127.0.0.1 : on y accède par un tunnel SSH ou par Tailscale |
Le navigateur est la partie lourde. Chaque page que l’agent ouvre est dessinée, défilée et capturée, souvent en boucle. C’est là que le GPU intervient.
2. Le navigateur : 20× plus rapide avec le GPU
Sur un serveur sans GPU, Chrome se rabat sur SwiftShader, une carte graphique émulée par le processeur. Même page WebGL en 1080p, Chrome headless, serveur 4 vCPU :
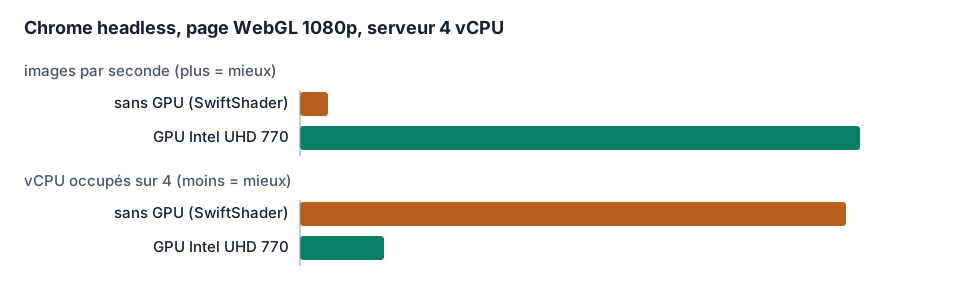
Pour un agent, la deuxième ligne compte autant que la première : quand le navigateur prend 3,9 vCPU sur 4, la Gateway, les appels au modèle et vos skills attendent. Une page lourde (une carte, un tableau de bord, une vidéo) suffit à ralentir tout l’assistant.
3. Ce que voient les sites web
Les sites qui luttent contre les robots lisent la carte graphique annoncée par le navigateur
(WEBGL_debug_renderer_info) :
| Configuration du navigateur | Carte graphique annoncée |
|---|---|
| Serveur sans GPU, headless par défaut | SwiftShader (émulée) |
| Serveur sans GPU, écran virtuel | pas de WebGL du tout |
| Serveur avec l’Intel UHD 770 | Intel UHD Graphics 770 |
SwiftShader ou l’absence de WebGL est un signe classique de navigateur automatisé. Un vrai GPU
ne rend pas un agent invisible, et vous devez respecter les conditions de chaque site, mais il
supprime une raison évidente d’être bloqué ou de recevoir des vérifications sans fin. Les détails
et les options Chrome que nous avons utilisées sont dans
notre article sur le navigateur pour agent IA.
4. Médias et modèles locaux
OpenClaw gère les médias (images, audio, vidéo) envoyés depuis vos messageries. Sur nos serveurs, le même GPU Intel dispose aussi :
- d’un moteur vidéo (Quick Sync / VA-API) pour convertir ou compresser des vidéos sans charger le CPU : voir nos commandes ffmpeg Quick Sync ;
- de la prise en charge d’OpenVINO pour la vision, l’OCR et les petits modèles de langage sur le GPU : voir l’inférence IA sur un GPU intégré.
Pour le modèle principal, une API hébergée (Anthropic, OpenAI…) reste le choix le plus capable ; un petit modèle local servi par Ollama suffit pour les tâches simples et garde vos données sur votre serveur.
5. Pourquoi un serveur plutôt que votre propre ordinateur
- Isolation : OpenClaw peut exécuter des commandes et lire des fichiers. Sur un serveur dédié, il ne voit que ce que vous y mettez, pas votre machine personnelle.
- Toujours allumé : votre assistant répond la nuit et quand votre portable est fermé.
- Accès privé : laissez la Web Control UI sur
127.0.0.1et accédez-y par un tunnel SSH ou par Tailscale, sans aucun port ouvert sur Internet. Limitez qui peut parler à l’agent avec les listes d’autorisation d’OpenClaw.
6. Mac mini ou serveur Linux GPU ?
| Serveur Linux GPU (iGPU Start / Power) | Mac mini dédié (M4) | |
|---|---|---|
| Prix | à partir de 14,99 € / 29,99 € HT par mois | à partir de 95 € par mois |
| Navigateur sur le GPU | oui, Intel UHD 770 | oui, GPU Apple |
| Fonctions propres à Apple (iMessage, apps Apple) | non | oui |
| Idéal pour | un agent toujours allumé qui navigue, convertit des médias, fait tourner de petits modèles locaux | les agents qui ont besoin de macOS |
Les deux sont disponibles chez nous : ne choisissez le Mac mini que si votre agent a besoin de macOS.
Quelle offre ?
iGPU Start (2 vCPU, 8 Go) suffit pour un agent qui navigue de temps en temps. S’il navigue toute la journée, traite de la vidéo ou fait tourner un modèle local à côté de la Gateway, prenez iGPU Power (4 vCPU, 14 Go, deux fois plus de GPU que Start) : nos chiffres de navigateur ont été mesurés sur 4 vCPU.
Vous le voulez prêt à l’emploi ? Demandez-le par e-mail à la commande (contact@linuxgpu.eu) : nous pouvons livrer le serveur avec les prérequis d’OpenClaw installés et Chrome configuré pour afficher sur le GPU. Il ne vous reste qu’à connecter votre propre compte de modèle et vos messageries.
Essayer
Voir les offres : serveurs iGPU à partir de 14,99 € HT par mois, Mac mini dédié à partir de 95 € par mois.