OpenClaw en un servidor GPU: por qué la GPU importa para tu agente de IA
OpenClaw es el asistente de IA de código abierto que todo el mundo instala este año: un Gateway que ejecutas en tu propia máquina y que conecta tus aplicaciones de mensajería con un agente de IA capaz de navegar por la web, ejecutar comandos, manejar archivos y medios, y usar skills. Mucha gente compra un Mac mini solo para tenerlo siempre encendido. Un servidor hace el mismo trabajo, siempre encendido y lejos de tu ordenador personal. Este artículo explica qué cambia una GPU para OpenClaw en un servidor, con las mediciones de nuestra prueba del navegador para agentes de IA.
En resumen
- OpenClaw maneja un navegador real (un perfil de Chromium gestionado: pestañas, clics, capturas de pantalla, PDF). Sin GPU, ese navegador dibuja las páginas con el procesador: en nuestra prueba, una página WebGL en 1080p iba a 13 imágenes/s con 3,9 de 4 vCPU ocupadas. Con la Intel UHD 770: unas 260 imágenes/s con 0,6 vCPU.
- Los sitios web ven una tarjeta gráfica real:
Intel UHD Graphics 770en lugar deSwiftShadero de ningún WebGL, que es una señal típica de un navegador automatizado. - La CPU queda libre para el propio agente: el Gateway, sus herramientas y tus skills.
- Los medios y los modelos locales también pueden usar la GPU: conversión de vídeo con Quick Sync, modelos de imagen y de texto con OpenVINO.
No hemos medido OpenClaw en sí: las cifras siguientes vienen de nuestra prueba de Chrome manejado por un agente de IA en el mismo hardware (4 vCPU, Intel UHD 770, Debian 13).
1. Lo que OpenClaw necesita en un servidor
Según la documentación oficial:
| Necesidad | Lo que usa OpenClaw |
|---|---|
| Entorno | Node 24 o 26, un proceso Gateway (Linux, macOS, Windows/WSL2, Docker) |
| Modelo | una clave de API de un proveedor, o modelos locales (un servidor Ollama, a través de su API nativa) |
| Navegador | un perfil de navegador gestionado (Chrome, Chromium, Brave o Edge) que controla el agente: pestañas, clics, escritura, instantáneas, capturas de pantalla, PDF |
| Acceso | la Web Control UI escucha en 127.0.0.1: se accede a ella por un túnel SSH o por Tailscale |
El navegador es la parte pesada. Cada página que abre el agente se dibuja, se desplaza y se captura, a menudo en bucle. Ahí es donde entra la GPU.
2. El navegador: 20× más rápido con la GPU
En un servidor sin GPU, Chrome recurre a SwiftShader, una tarjeta gráfica emulada por el procesador. Misma página WebGL en 1080p, Chrome headless, servidor de 4 vCPU:
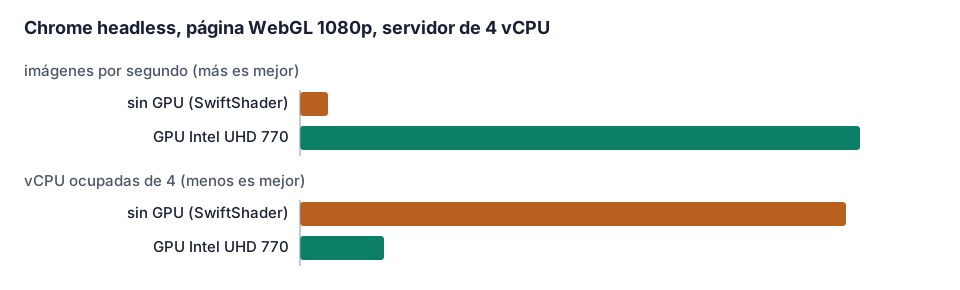
Para un agente, la segunda línea importa tanto como la primera: cuando el navegador ocupa 3,9 de 4 vCPU, el Gateway, las llamadas al modelo y tus skills esperan. Basta una página pesada (un mapa, un panel de control, un vídeo) para ralentizar todo el asistente.
3. Lo que ven los sitios web
Los sitios que luchan contra los bots leen la tarjeta gráfica que declara el navegador
(WEBGL_debug_renderer_info):
| Configuración del navegador | Tarjeta gráfica declarada |
|---|---|
| Servidor sin GPU, headless por defecto | SwiftShader (emulada) |
| Servidor sin GPU, pantalla virtual | ningún WebGL |
| Servidor con la Intel UHD 770 | Intel UHD Graphics 770 |
SwiftShader o la falta de WebGL es una señal clásica de navegador automatizado. Una GPU real no
hace invisible a un agente, y debes respetar las condiciones de cada sitio, pero elimina un motivo
evidente para que te bloqueen o te muestren verificaciones sin fin. Los detalles y las opciones de
Chrome que usamos están en
nuestro artículo sobre el navegador para agentes de IA.
4. Medios y modelos locales
OpenClaw procesa los medios (imágenes, audio, vídeo) que envías desde tus aplicaciones de mensajería. En nuestros servidores, la misma GPU Intel también tiene:
- un motor de vídeo (Quick Sync / VA-API) para convertir o reducir vídeos sin cargar la CPU: consulta nuestros comandos ffmpeg con Quick Sync;
- compatibilidad con OpenVINO para visión, OCR y modelos de lenguaje pequeños en la GPU: consulta inferencia de IA en una GPU integrada.
Para el modelo principal, una API alojada (Anthropic, OpenAI…) sigue siendo la opción más capaz; un modelo local pequeño servido por Ollama basta para tareas sencillas y mantiene tus datos en tu servidor.
5. Por qué un servidor y no tu propio ordenador
- Aislamiento: OpenClaw puede ejecutar comandos y leer archivos. En un servidor propio solo ve lo que pongas en él, no tu máquina personal.
- Siempre encendido: tu asistente responde de noche y con el portátil cerrado.
- Acceso privado: deja la Web Control UI en
127.0.0.1y accede a ella por un túnel SSH o por Tailscale, sin ningún puerto abierto en Internet. Limita quién puede hablar con el agente con las listas de permitidos de OpenClaw.
6. ¿Mac mini o servidor Linux GPU?
| Servidor Linux GPU (iGPU Start / Power) | Mac mini dedicado (M4) | |
|---|---|---|
| Precio | desde 14,99 € / 29,99 € sin IVA al mes | desde 95 € al mes |
| Navegador en la GPU | sí, Intel UHD 770 | sí, GPU de Apple |
| Funciones exclusivas de Apple (iMessage, apps de Apple) | no | sí |
| Ideal para | un agente siempre encendido que navega, convierte medios y ejecuta modelos locales pequeños | agentes que necesitan macOS |
Ofrecemos los dos: elige el Mac mini solo si tu agente necesita macOS.
¿Qué plan elegir?
iGPU Start (2 vCPU, 8 GB) basta para un agente que navega de vez en cuando. Si navega todo el día, procesa vídeo o ejecuta un modelo local junto al Gateway, elige iGPU Power (4 vCPU, 14 GB, el doble de GPU que Start): nuestras cifras del navegador se midieron con 4 vCPU.
¿Lo quieres listo para usar? Pídelo por correo al hacer el pedido (contact@linuxgpu.eu): podemos entregarte el servidor con los requisitos de OpenClaw instalados y Chrome configurado para renderizar en la GPU. Después solo tienes que conectar tu propia cuenta del modelo y tus aplicaciones de mensajería.
Pruébalo
Ver los planes: servidores iGPU desde 14,99 € sin IVA al mes, Mac mini dedicado desde 95 € al mes.